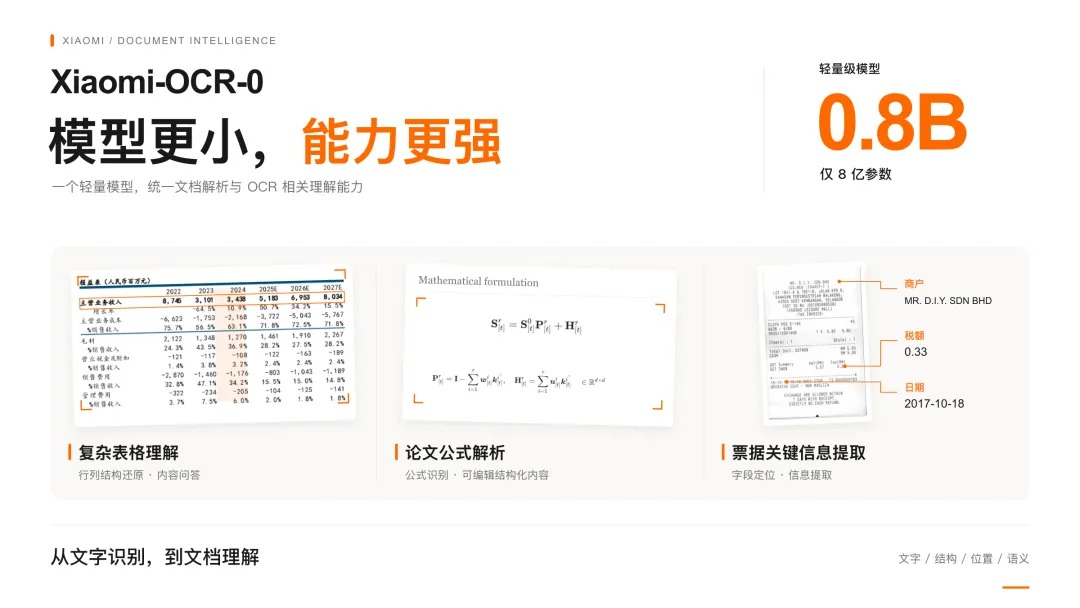
10月30日,小米官方宣布开源轻量级文档理解模型Xiaomi-OCR-0,模型权重与推理代码已同步上线HuggingFace和GitHub。该模型参数规模为0.8B,定位是单一模型同时覆盖文档解析、关键信息抽取与OCR视觉问答三类任务。
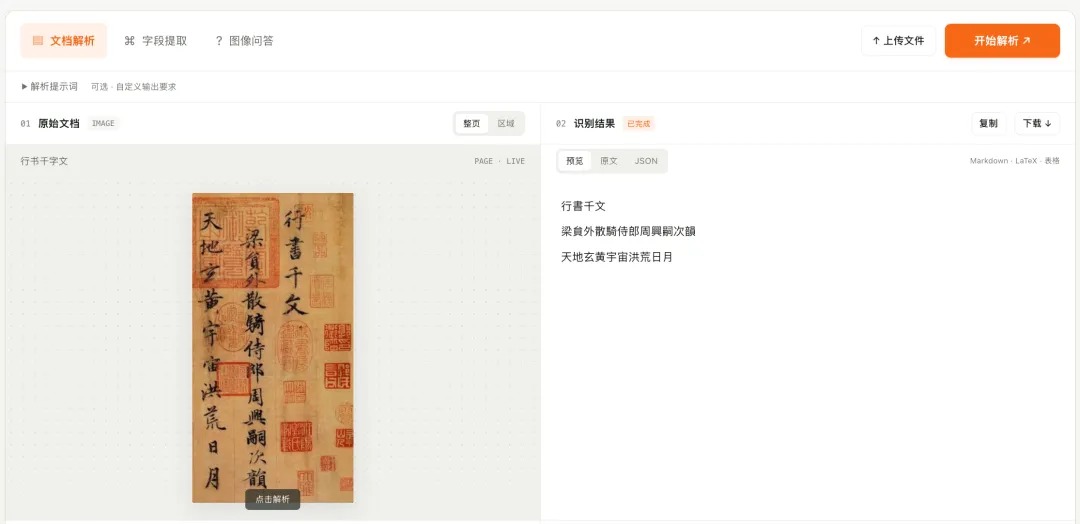
在文档解析方向,该模型可识别正文、表格与数学公式,按阅读顺序输出结构化结果,原生支持Markdown、LaTeX格式。关键信息抽取面向发票、收据、卡证和业务表单,依据指定字段定位并输出JSON等结构化数据。OCR视觉问答则允许围绕文档与图表内容进行跨区域检索、数值计算和语义推理。据官方披露,Xiaomi-OCR-0基于Qwen3.5-0.8B-Base基座构建,训练累计使用约1.7亿条OCR与文档理解样本,数据侧采用异构专家共识机制,并引入预测—重渲染—视觉比对的闭环校验流程,训练分为Q-Mask文本锚定、OCR持续预训练和混合任务强化学习三个阶段。
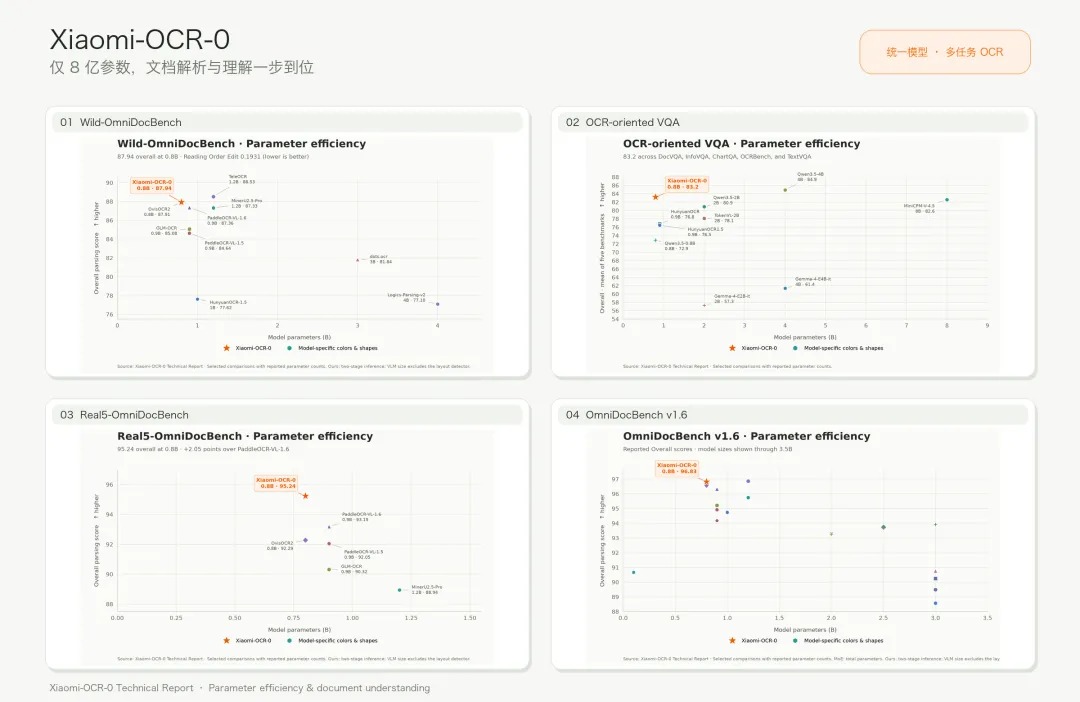
评测结果显示,在模拟扫描、纸张弯曲、屏幕翻拍、光照变化和倾斜拍摄五种真实采集方式的Real5-OmniDocBench上,Xiaomi-OCR-0得分为95.24分,在其对比模型中排名第一;综合基准OmniDocBenchv1.6中得分96.83分,位列总榜第二,在1B以下参数模型中排名第一。文档理解方面,该模型在DocVQA、InfoVQA、ChartQA、OCRBench和TextVQA五项基准上平均分为83.2分,高于HunyuanOCR-1.5、TokenVL-2B和TextHawk2等对比模型。落地层面,相关技术已用于手机端超级小爱,支持提取外卖取餐码、快递取件码、排队号等时效性信息,以及账单卡证字段抽取和日程卡片生成。小米除公开模型权重与推理代码外,还提供浏览器交互式Demo、MCP服务以及AgentSkill工具包。
来源:一电快讯
返回第一电动网首页 >
以上内容由AI创作,如有问题请联系admin#d1ev.com(#替换成@)沟通,AI创作内容并不代表第一电动网(www.d1ev.com)立场。
文中图片源自互联网或AI创作,如有侵权请联系邮件删除。


 京公网安备
11010502033163号
